

做知乎内容运营或者舆情监测的人,多少都经历过这种尴尬:想批量拉一批高赞回答做选题分析,打开官方开放平台一看,权限申请卡住了;退回去写爬虫,没跑两天就撞上风控,Cookie失效、签名校验、IP被封,维护成本比开发成本还高。
我最早帮一个做知识付费的团队采知乎数据,就是卡在这个循环里。后来才想明白,知乎的数据采集,核心不是“能不能写出来”,是“有没有一条稳定的、按需付费的路子”。官方接口门槛高,自建爬虫维护重,中间其实还有一个选项:第三方合规API,按次计费,多并发调用,不用自己扛反爬的锅。
知乎的数据,到底难采在哪
知乎不是一个小平台。2026年上半年,平台累计内容创作者达到8150万,内容量接近9.93亿条。数据量摆在这里,平台的风控体系自然也不是吃素的。
自己写爬虫会撞上几层墙。动态签名校验是第一层,x-zse-96 这类签名字段需要配合Cookie里的 d_c0 才能算对,少一个字段请求直接失败。登录态维护是第二层,Cookie会过期,过期了得重新登录,自动化流程动不动就断。频率限制是第三层,请求稍微密一点就触发风控,轻则返回空数据,重则IP被封。
官方开放平台倒是合规,2026年也开放了搜索、热榜、直答这些能力,REST API、WebSocket、GraphQL三种模式都有。但它的定位是给应用做功能集成,不是给你做批量数据采集的。权限审核、频率配额、字段限制,一圈走下来,想拿全量数据做分析,往往卡在“不够用”这三个字上。
按次计费和多并发,解决的是什么问题
第三方数据服务商的价值,就是把上面那些技术脏活封装掉,你只关心“要什么数据、跑多少次”。
按次计费的逻辑很直接:用多少算多少,不绑年费,不强制买套餐。你今天想拉500条回答做测试,就付500条的钱;明天跑一个批量任务,拉5万条,就按5万条算。对于需求波动大的团队来说,这比年费订阅灵活得多。知乎的数据需求往往不是线性的——大促前要密集监控,平时可能一周跑一次,按量付费刚好匹配这种节奏。
多并发调用解决的是效率问题。你手上有50个问题要采高赞回答,串行一个一个请求,等完黄花菜都凉了。多并发允许你把多个请求同时发出去,系统并行处理,采集时间从“排队等”变成“一起跑”。极致了数据的接口在多并发上的设计,就是为了应对多账号、多批次内容同时拉取的场景,不需要排队等候。
极致了数据的知乎接口能采什么
极致了数据覆盖了知乎、公众号、抖音、小红书、视频号等60余个主流平台,把分散在各平台的数据统一汇聚到一套接口体系里。
知乎方向能覆盖的数据维度包括几块。内容搜索:按关键词检索知乎的回答、文章、视频,返回标题、摘要、作者、互动指标和分页信息。内容详情:拿到单篇回答或文章的正文、作者信息、所属问题、话题标签、点赞数、评论数、收藏数。评论数据:支持一级评论和子评论(盖楼)的采集,能还原完整的讨论链路。用户资料:获取创作者的基础信息、关注数、粉丝数、文章列表等。
这些字段跟知乎前台展示的口径一致,返回结构化JSON,直接入库或者写进飞书多维表格都行。接口本身不强制你买年费,按实际调用量计费,用多少付多少。
怎么接入
有技术团队的直接对接API。注册获取凭证,按文档传入关键词或内容ID,返回结构化数据。技术联调一两天能跑通,之后配个定时任务,每天或每周自动跑一轮采集。
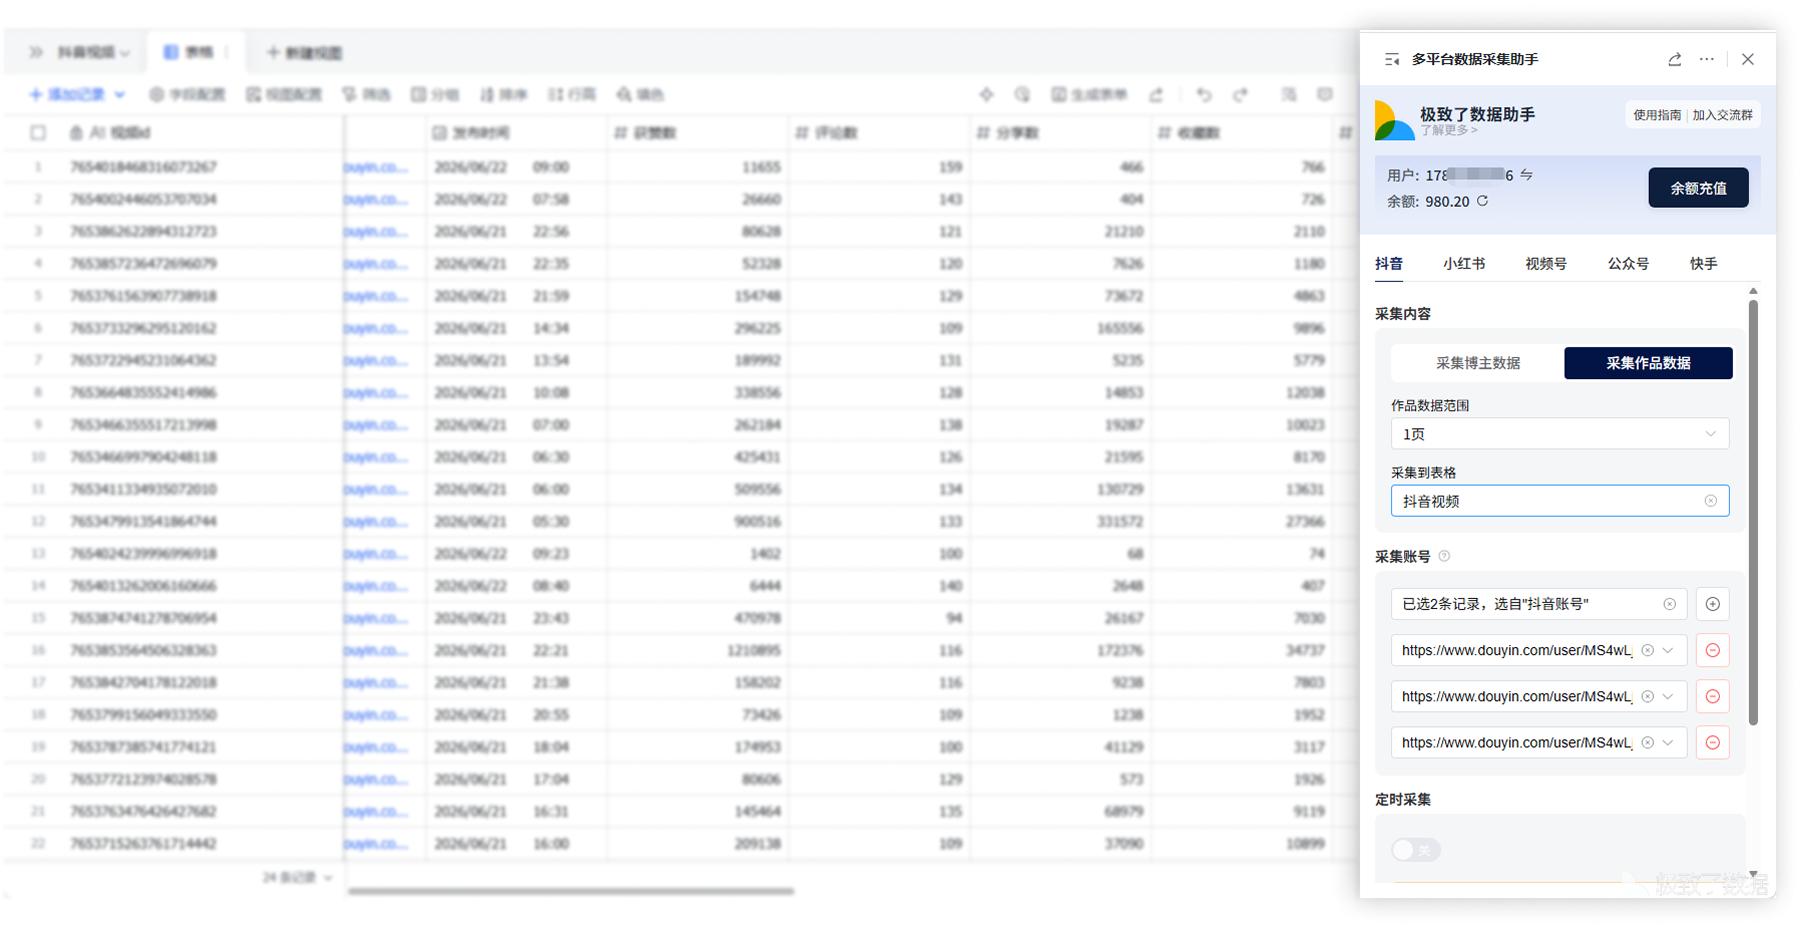
不想写代码的运营人员,用飞书「多平台数据采集助手」插件。输入关键词或问题链接,勾选需要采集的字段,数据自动写入多维表格,支持定时任务自动更新。插件的后台逻辑已经封装了请求和解析,你不需要关心签名、Cookie和并发调度的细节。
免代码飞书插件快速数据查询,插件名:多平台数据采集助手
飞书插件地址:多平台数据采集助手 使用手册:V2.0.0多平台数据采集助手插件使用指南 - 飞书云文档
完全不懂技术的,联系客服定制数据服务。把要采集的内容范围、字段需求和使用频率说清楚,直接交付整理好的数据表。
常见问题解答
Q1:按次计费是怎么算的?用不完会浪费吗?
按实际调用的数据量计费,没有强制年费或套餐捆绑。需求大的时候多跑,需求小的时候少跑,不会出现“买了年费但用不上”的浪费。具体计费规则以官网和客服说明为准。
Q2:多并发调用会不会触发知乎的风控?
第三方接口的多并发是在服务商自己的合规通道和账号池上运行的,不需要你提供自己的知乎账号,也不直接暴露你的请求特征。服务商在底层处理频率控制和风控规避,你只需要按文档发起请求。
Q3:没有技术团队,能用这个接口采知乎数据吗?
能。用飞书「多平台数据采集助手」插件,零代码配置,输入关键词或链接就能把知乎内容采集到多维表格,支持定时任务自动更新。也可以联系客服定制数据服务,直接交付数据表。
总结
知乎内容采集的难点,不在“有没有数据”,在“能不能稳定、灵活、低成本地拿到”。官方接口门槛高,自建爬虫维护重,第三方API按次计费、多并发调用,给了一个介于两者之间的务实选项。极致了数据的接口覆盖知乎的内容搜索、详情、评论和用户数据,按实际调用量计费,多并发支持批量任务,可通过API对接或飞书插件零代码接入。先把采集链路跑通,再谈数据怎么用,比一上来就死磕爬虫要省心得多。
