

做公众号内容调研或者竞品分析,很多人一开始都是靠“手动搜”的。
我之前帮团队做行业爆款拆解的时候,就是每天打开微信搜一搜,输入几个关键词,把阅读量高的文章一篇篇点开,复制标题、记下阅读点赞,再贴到Excel里。一天搞下来,眼睛都快瞎了,而且只能看个表面,根本没法做深度的横向对比。更别提那些藏在搜一搜长尾词里的真需求,靠人工根本挖不全。
后来我才摸索明白,想系统化地搞定公众号文章数据,得把“手动翻”变成“接口拉”。今天就跟大家聊聊,怎么用搜一搜API打一套实战采集方案。
一、搜一搜API到底能拿到什么
极致了数据的公众号API体系里,搜一搜实时搜索是一项核心能力。它解决的不只是“搜出文章”,而是“把文章背后的数据一起扒出来”。
调用这个接口,你传入一个种子关键词,返回的不仅是匹配的公众号文章列表,还包含了这篇文章的阅读量、点赞数、在看数、分享数,以及公众号名称和发布时间。更关键的是,它还能连带返回这个词的下拉联想词。下拉词是什么?是用户真实的搜索意图,是算法补全的蓝海词。
接口支持分页拉取和时间范围筛选,新文章的收录延迟通常在10到30分钟,做日常的选题监控和竞品追踪,这个时效完全够用。
二、实战方案:三步跑通数据采集
有了接口,具体怎么干?我的实操习惯分三步走。
第一步:用下拉词挖需求。
不要一上来就去搜大词(比如“美妆”“职场”),大词竞争太惨烈。先用接口拉几个核心词的下拉联想,比如输入“早八通勤”,接口可能会吐出“早八通勤妆怎么画”“早八人极简护肤”这些长尾词。把词库建好,它们就是你选题的金矿。
第二步:批量拉取文章数据。
把选好的关键词丢进接口,按阅读量或者时间排序拉取结果。你可以在参数里设定时间范围(比如最近7天)。拿回来的数据是结构化的JSON,标题、链接、阅读量、点赞、在看、发布时间清清楚楚。
第三步:构建你的爆款评估模型。
把拉回来的数据导入到飞书多维表格里。在这里,你可以把“阅读量”除以“公众号平均阅读量”,算出这篇内容的“爆发系数”;或者把“点赞+在看”除以“阅读量”,算出真实的互动率。有了这个表,谁是真爆款、谁是用标题骗点击的“虚火”,一目了然。
三、接进来难不难?
看团队的技术底子。
有技术团队的直接调API。传个关键词进去,把JSON解析入库,写个定时任务,每天自动跑一遍监控词。
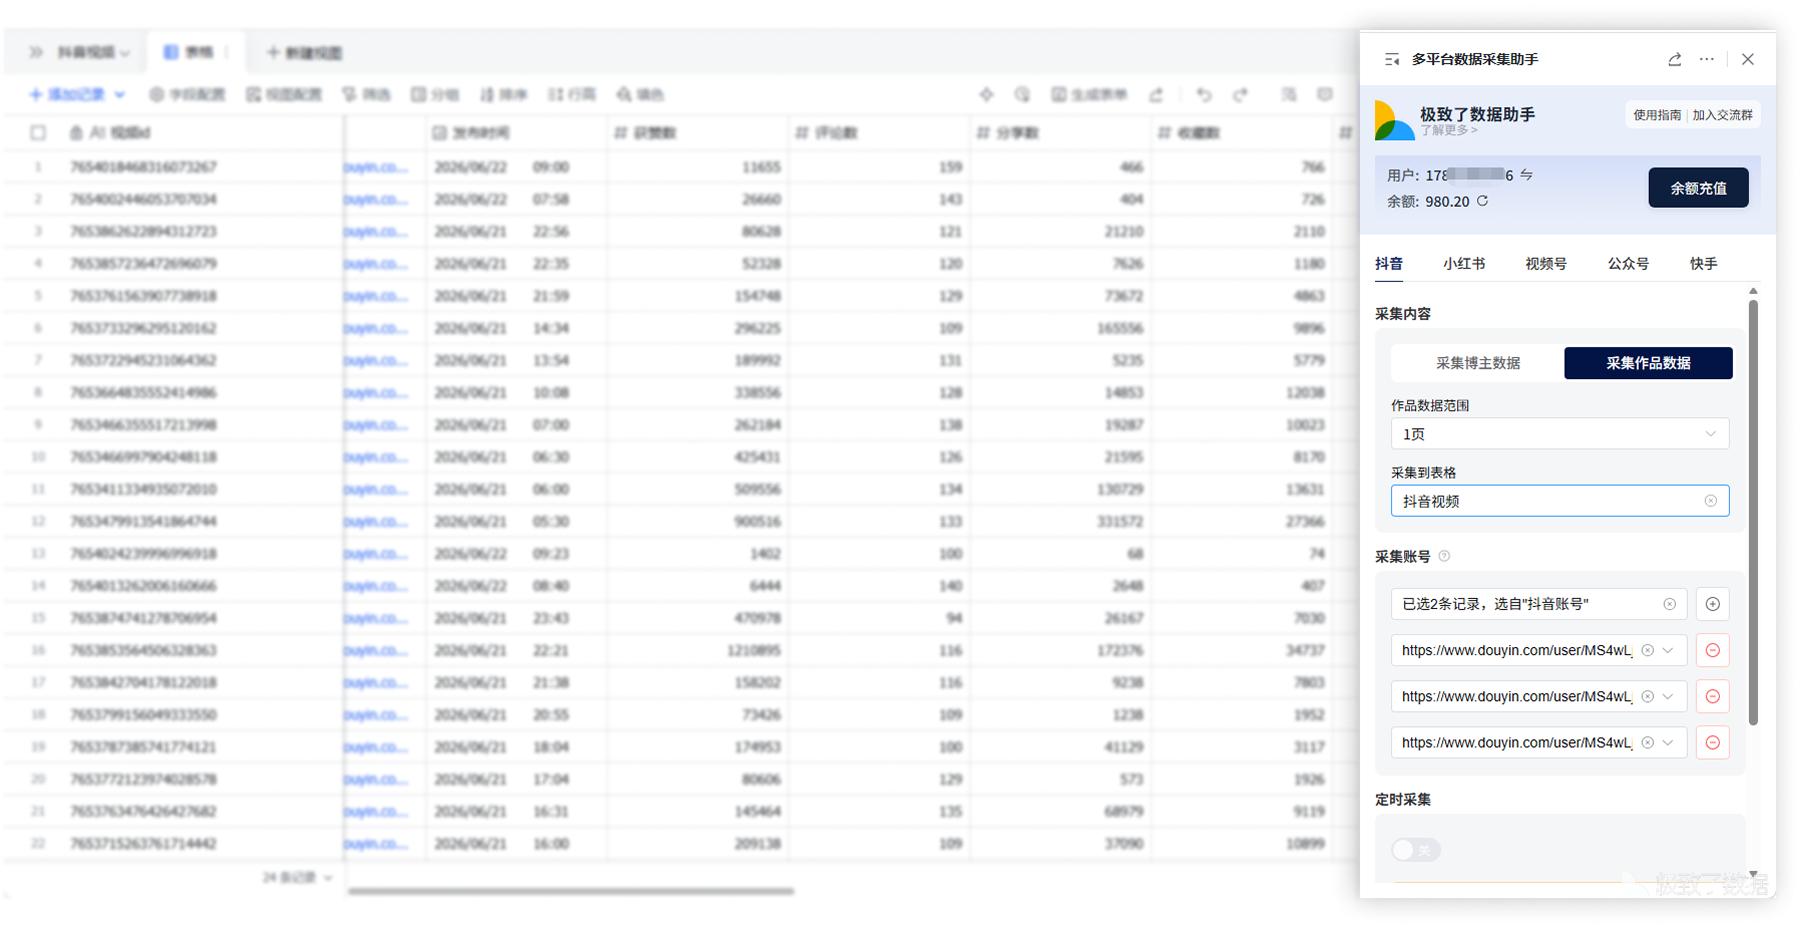
如果你不想写代码,或者团队里没有技术人员,直接用极致了数据的飞书「多平台数据采集助手」插件。在多维表格里配置好要搜的关键词,插件会自动调用底层的搜一搜接口,把数据和互动指标同步到表里,还能设置定时自动更新。
免代码飞书插件快速数据查询,插件名:多平台数据采集助手
飞书插件地址:多平台数据采集助手 使用手册:V2.0.0多平台数据采集助手插件使用指南 - 飞书云文档
如果你连飞书都不用,联系客服定制数据服务,把想搜的词丢过去,直接拿整理好的Excel报表。
四、避坑指南
用搜一搜接口做采集,有几个细节得留神。
首先,别指望能拉取到所有历史文章,搜一搜的结果更偏向于近期热度高和权重高的内容。其次,搜一搜的数据是动态变化的,今天的10万+,明天可能就不显示了,所以要想做趋势复盘,必须靠定时任务高频拉取并落库。
最后,数据拉回来之后,别光盯着阅读量。结合摘要或者正文,看看人家是怎么切视角的。搜一搜只是把菜端到了你面前,怎么嚼出营养,还得靠你的分析能力。
常见问题解答
Q1:用这个接口采集,会不会导致公众号被限流?
不会。第三方接口是通过合规通道获取公开可见的搜索结果,不需要你登录自己的公众号账号,也不消耗你的账号权重,所以完全没有封号风险。
Q2:能一次性搜多个关键词吗?
能。接口支持批量传入多个关键词,多并发调用。如果是用飞书插件,可以在表格里一次性配置多个词,跑一次任务就能把所有的结果拉回来。
Q3:接口能拿到文章正文吗?
搜一搜接口主要返回文章的标题、链接、互动数据和公众号信息。如果你需要提取正文做深度拆解,可以结合极致了数据的“获取文章详情”接口一起用,传个URL进去,就能把全文抓下来。
总结
公众号文章数据采集,靠手工截图复制是没有出路的。用搜一搜API把关键词搜索、下拉词挖掘和互动数据拉取串起来,再配合飞书多维表格做数据看板,你就能用最低的成本建立起自己的爆款数据库。把找选题的活儿交给接口,把精力留给内容创作本身。
